
This repository contains comprehensive implementations and evaluations of five advanced classification algorithms applied to multimodal datasets. The primary objective was to achieve high-accuracy classification on both student behavioral data (dataset-1) and network traffic patterns (dataset-2), with successfully obtained accuracy metrics ranging between 96-99% across algorithms.
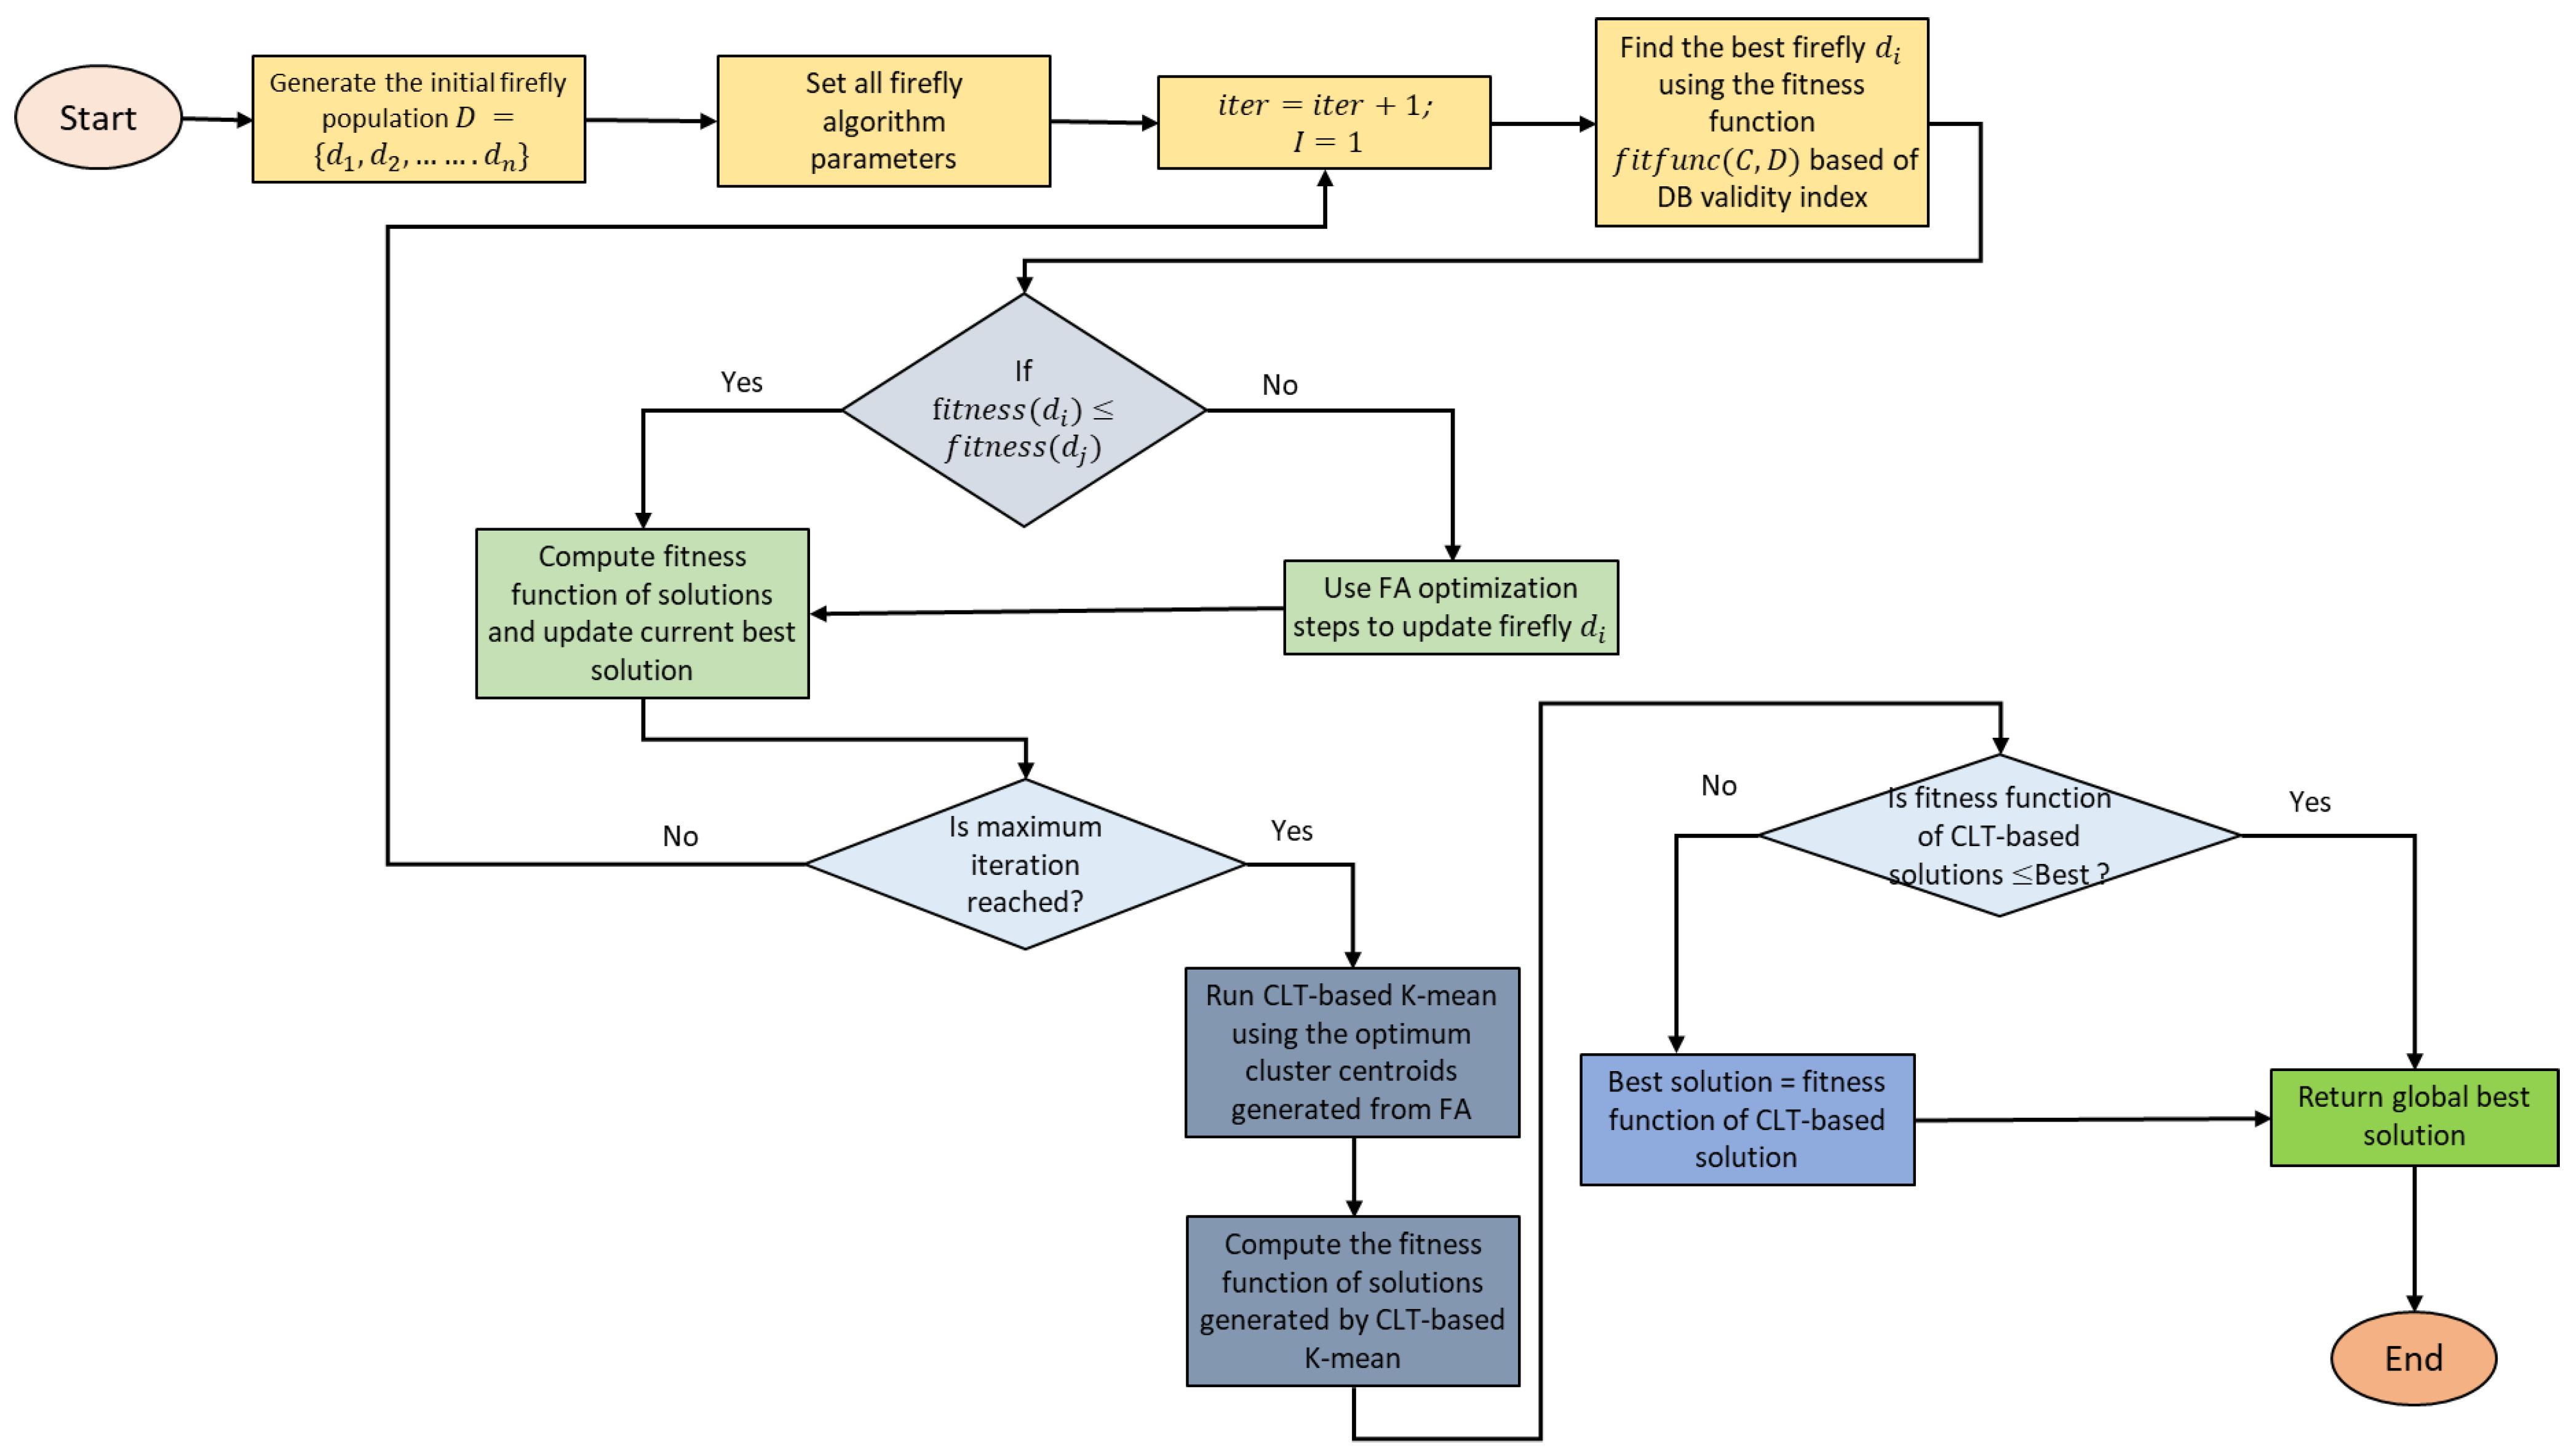
A hybrid metaheuristic approach combining Firefly Algorithm's luminosity-based attraction mechanics with Harmony Search's improvisation strategies to optimize classifier parameters and feature selection. The implementation leverages dynamic control parameters that adjust through iterations to balance exploration and exploitation.
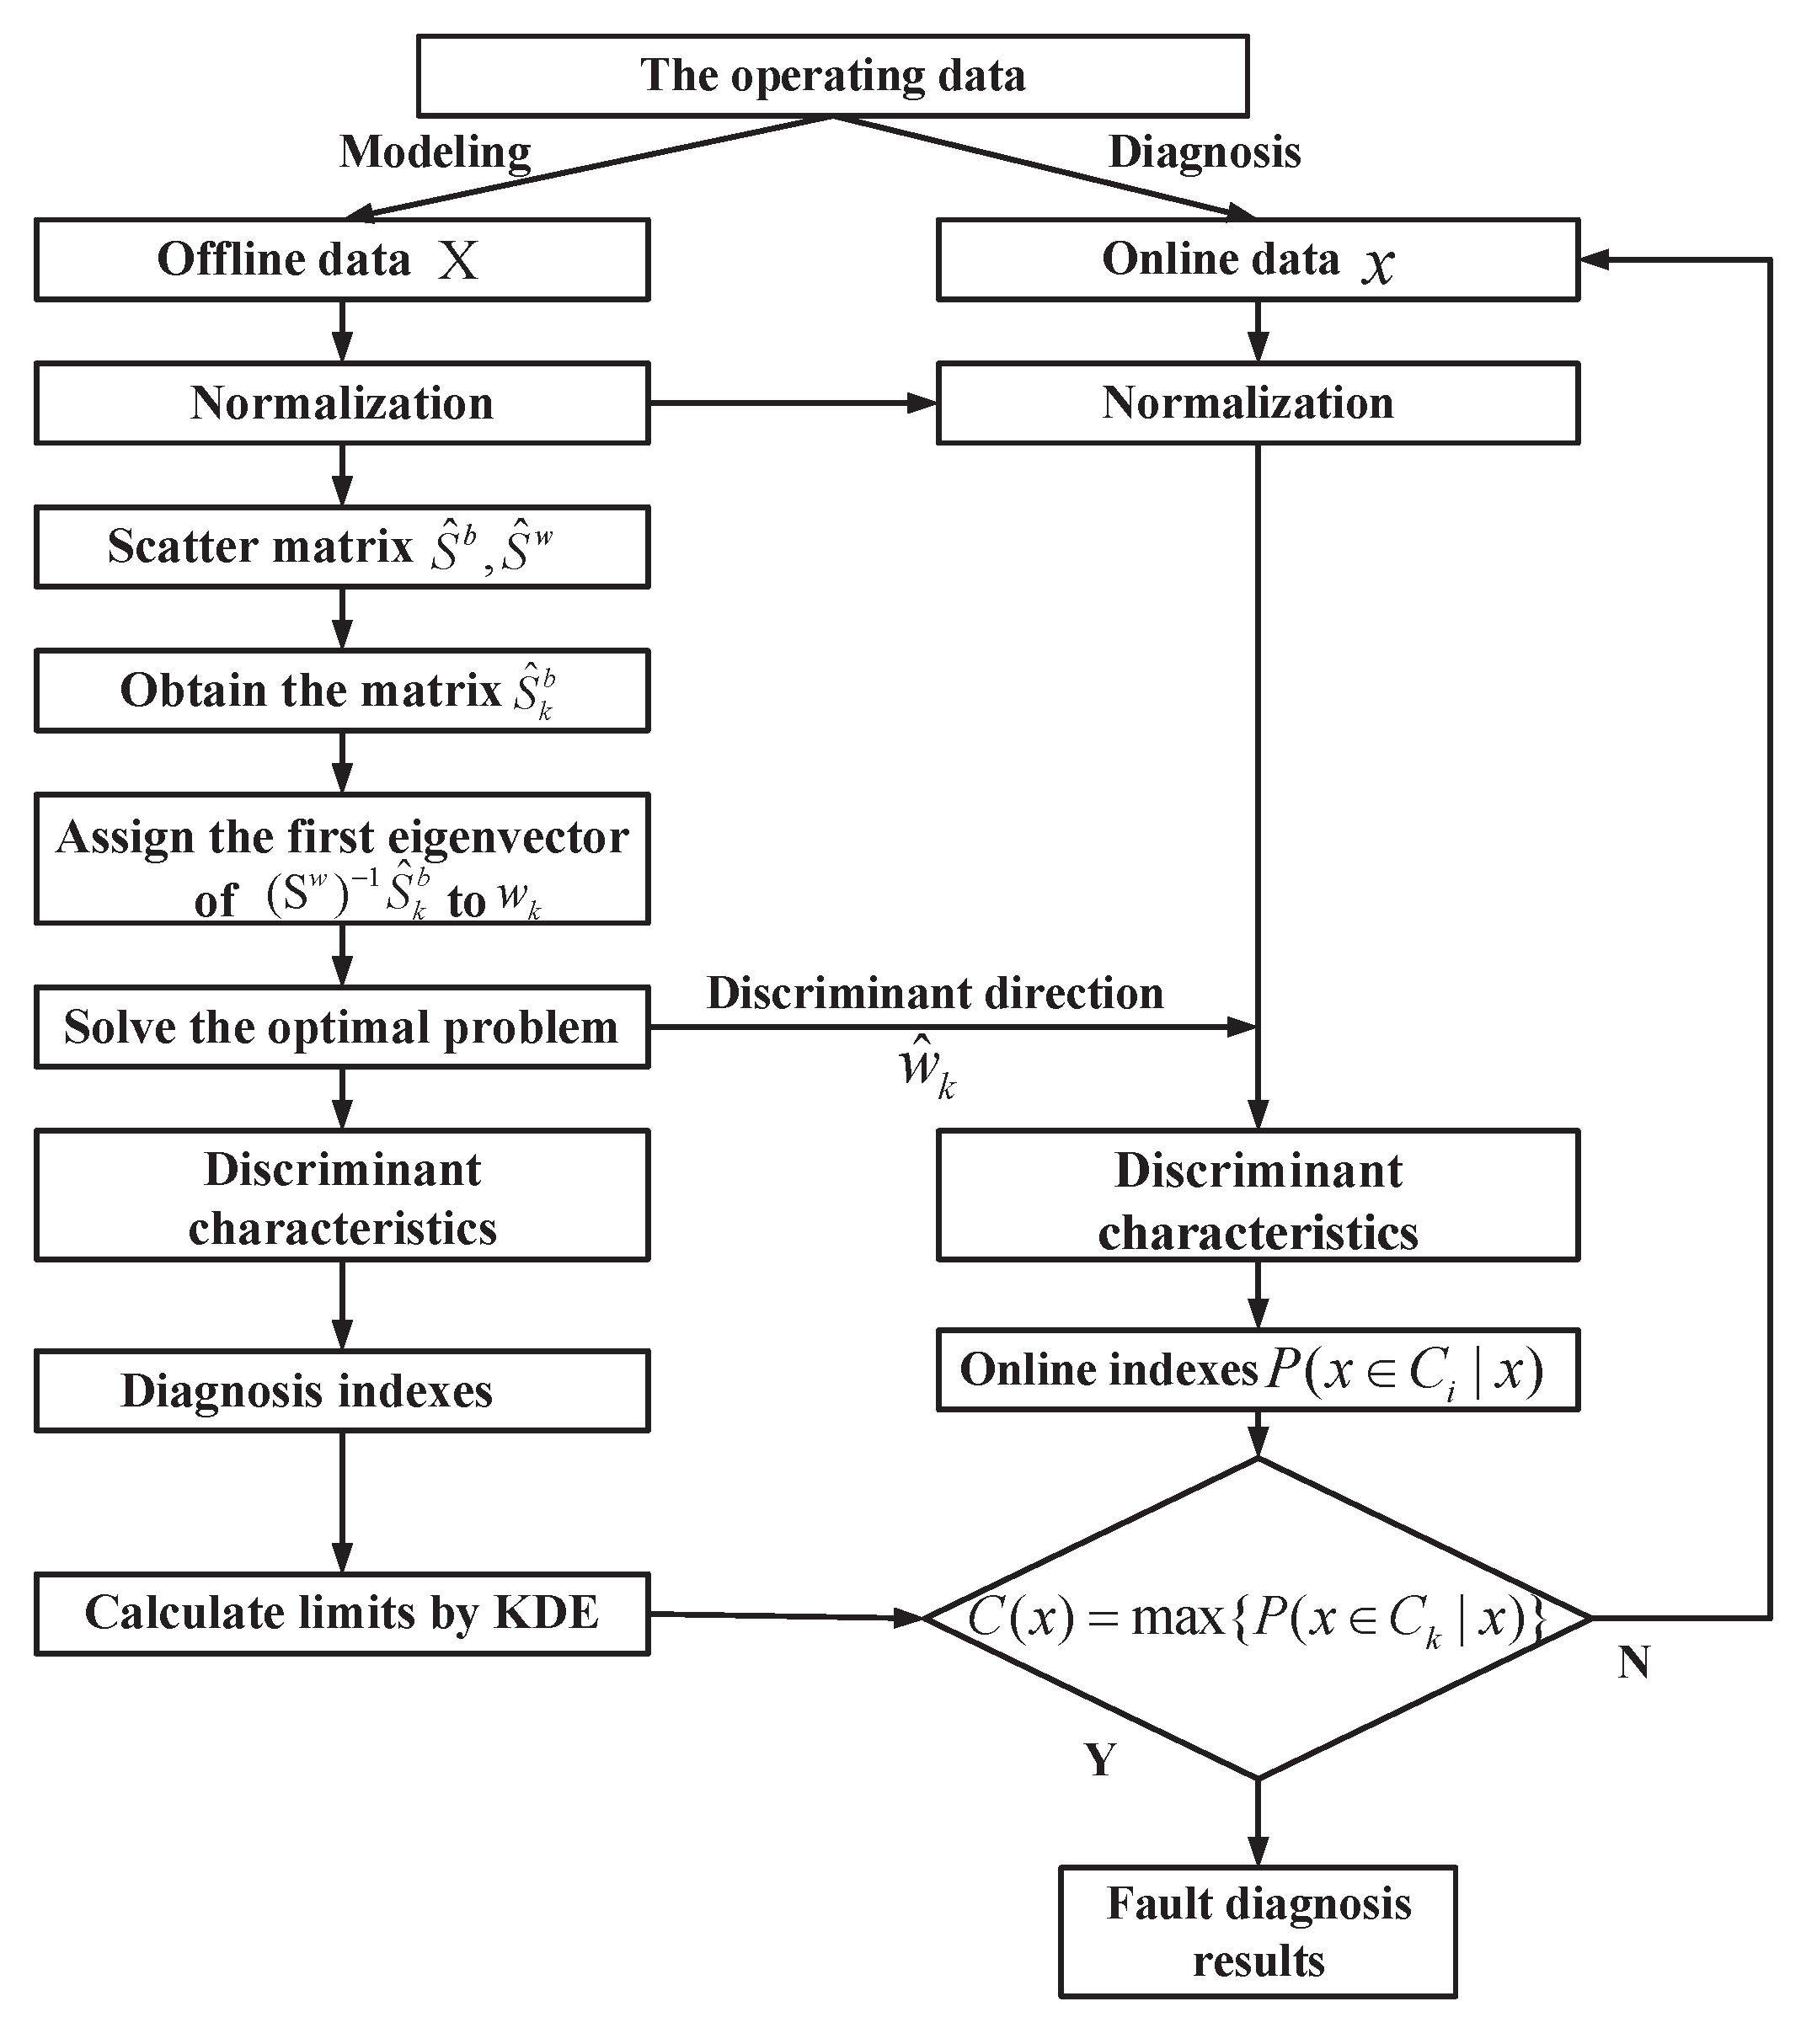
A dimensionality reduction and classification technique that maximizes the ratio of between-class scatter to within-class scatter, projecting high-dimensional data onto a lower-dimensional space while preserving class separability through eigenvalue decomposition of scatter matrices.
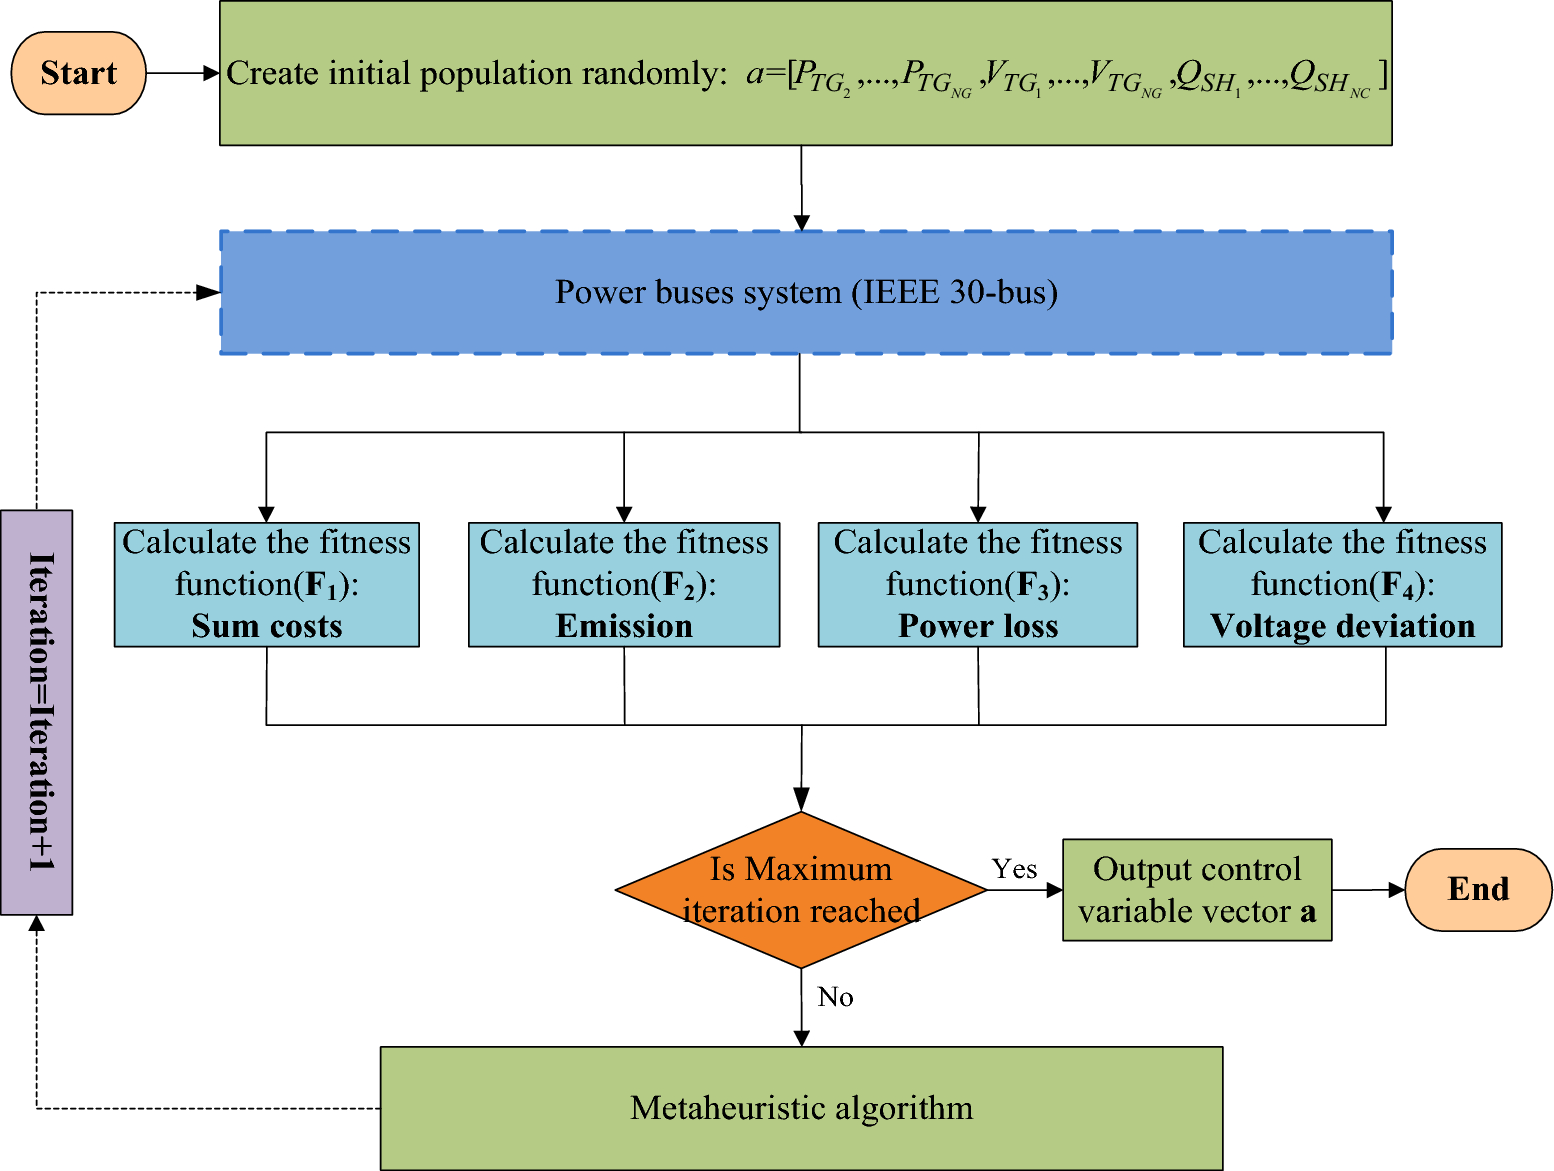
A multi-objective optimization approach that simultaneously optimizes classification accuracy, model complexity, and computational efficiency without requiring gradient information, using Pareto dominance principles to drive the search toward optimal classifier configurations.
Implementation of fuzzy rule-based classification system with adaptive membership functions. The approach utilizes linguistic variables and fuzzy inference systems to handle uncertainty and ambiguity in the feature space, with rule weights optimized through evolutionary algorithms.

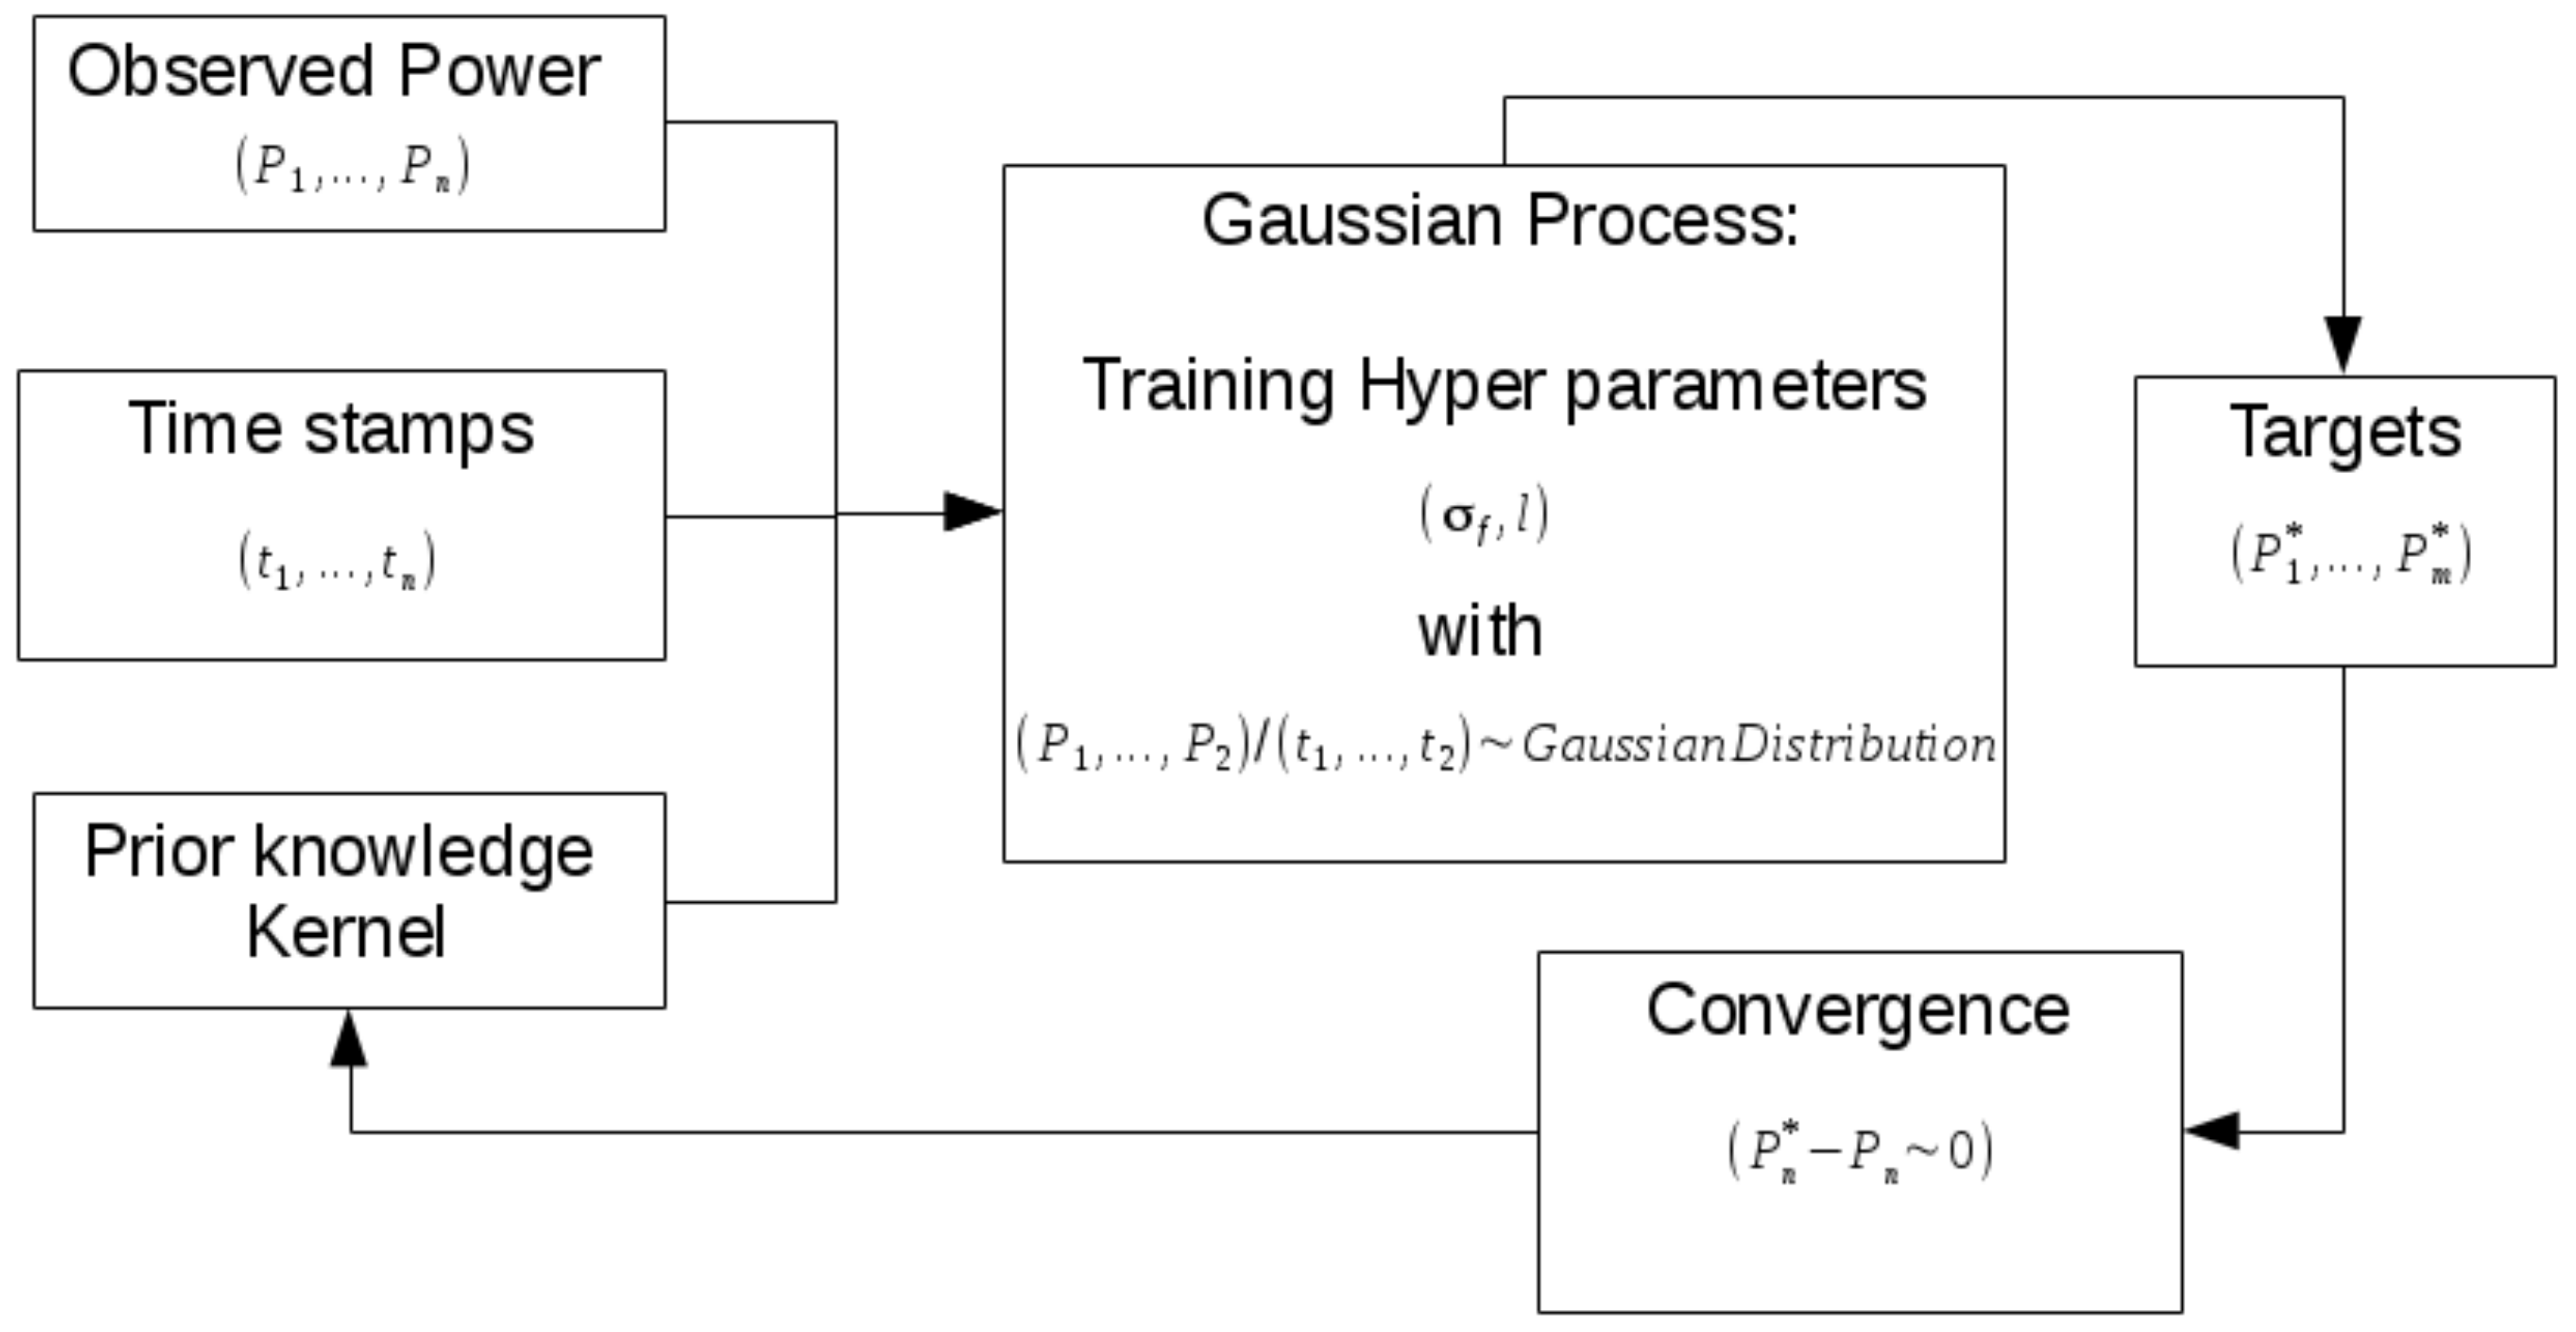
Probabilistic classification leveraging Gaussian Process priors with custom kernels optimized for each dataset's characteristics. This Bayesian approach provides uncertainty quantification alongside predictions, utilizing MCMC techniques for hyperparameter optimization.
ADASYN (Adaptive Synthetic Sampling) and SMOTE (Synthetic Minority Over-sampling Technique) are specialized resampling approaches that address class imbalance by generating synthetic samples in the feature space. These techniques improve classifier performance on minority classes by creating balanced training distributions while preserving decision boundaries.
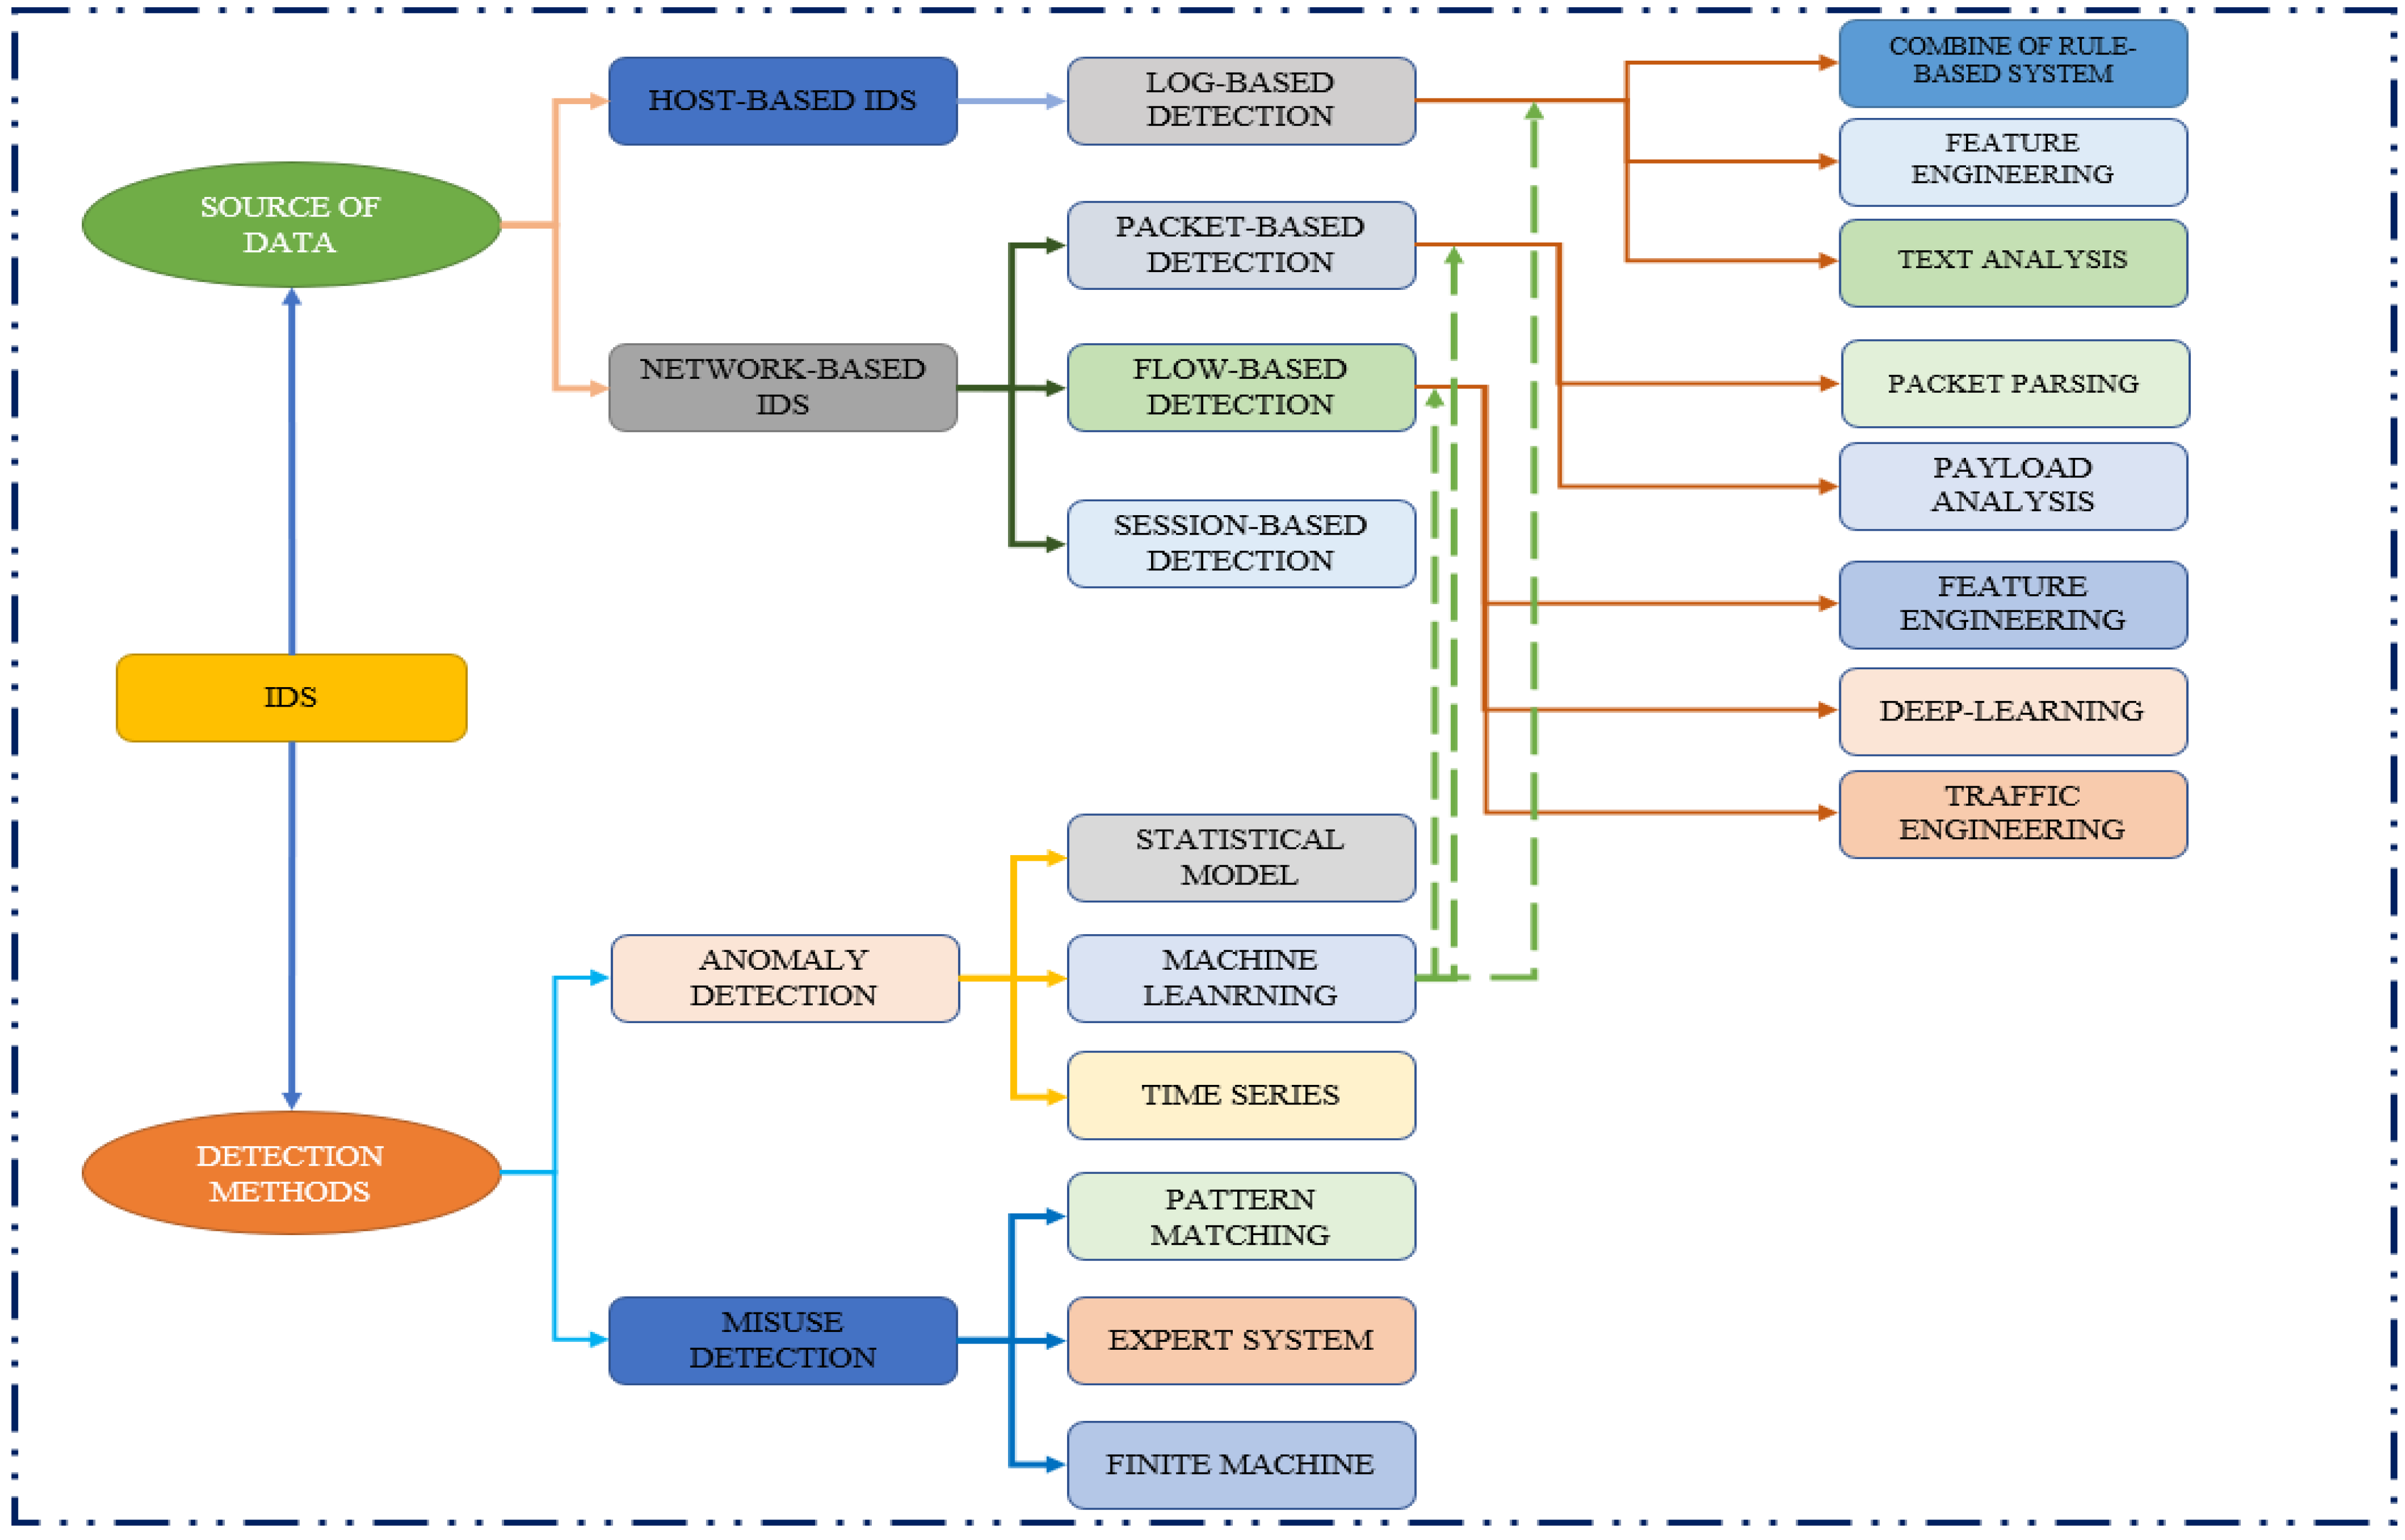
- Features: Academic performance metrics, behavioral indicators, socioeconomic factors.
- Classes: Multiple student performance categories.
- Preprocessing: Normalization, outlier detection, missing value imputation using KNN.
- Features: Packet statistics, flow metrics, temporal patterns, protocol-specific indicators.
- Classes: Traffic categories (benign/malicious with sub-classifications).
- Preprocessing: Feature scaling, dimensionality reduction, temporal aggregation.
Each algorithm implementation follows an identical rigorous experimental protocol.
- K-fold cross-validation (K=2) with stratified sampling to preserve class distributions.
- Consistent random state (42) for reproducibility across experiments.
- Decision Tree: Optimized with pruning parameters to control complexity.
- K-Nearest Neighbors: Distance metrics and neighborhood sizes tuned per dataset.
- Logistic Regression: Regularization parameters optimized with L1/L2 penalties.
- Classification Accuracy: Overall correct classification rate.
- Precision, Recall, F1: Class-specific and weighted-average metrics.
- Balanced Accuracy: Accuracy adjusted for class imbalance.
- Matthews Correlation Coefficient (MCC): Correlation between predicted and actual classes.
- Cohen's Kappa: Agreement assessment corrected for chance.
- Confusion Matrix Derivatives: TPR, TNR, FPR, FNR calculated per class.
- Log Loss: Probabilistic prediction quality assessment.
- Computational Efficiency: Training and inference timing benchmarks.
- 20% random sampling strategy for efficient algorithm benchmarking.
- Imbalanced class handling through RandomUnderSampler implementation.
iitp-classification-task/
├── algorithms/                           # Algorithm implementations
│   ├── algorithm-1-fho/                  # Firefly-Harmony Optimization
│   │   ├── fho-on-dataset-1/             # FHO applied to student data
│   │   │   ├── results/                  # Complete evaluation results
│   │   │   │   ├── confusion_matrices/   # Per-fold confusion visualizations
│   │   │   │   ├── models/               # Serialized trained models
│   │   │   │   ├── class_distribution.png  # Class distribution analysis
│   │   │   │   ├── class_performance.png   # Per-class performance metrics
│   │   │   │   ├── fitness_history_fold_*.png  # Convergence tracking
│   │   │   │   ├── metrics.csv           # Comprehensive metrics table
│   │   │   │   ├── performance_metrics.png  # Comparative metrics visualization
│   │   │   │   ├── timing_plot.png       # Computational efficiency analysis
│   │   │   │   └── timing.csv            # Detailed timing measurements
│   │   │   └── fho-1.ipynb               # Implementation notebook with documentation
│   │   └── fho-on-dataset-2/             # FHO applied to network traffic data
│   │       └── ...                       # Similar structure as above
│   ├── algorithm-2-fld/                  # Fisher's Linear Discriminant implementation
│   ├── algorithm-3-fofmoa/               # First-Order-Free Multi-Objective Algorithm
│   ├── algorithm-4-fuzzy-logic/          # Fuzzy Logic classification system
│   └── algorithm-5-gaussian-process/     # Gaussian Process implementation
├── datasets/                             # Input data directory
│   ├── dataset-1.csv                     # Student behavioral data
│   └── dataset-2.csv                     # Network traffic data
├── code-template.ipynb                   # Base implementation template
└── README.md                             # This documentation file
# Create and activate virtual environment.
python -m venv env
source env/bin/activate  # On Windows: env\Scripts\activate

# Install requirements.
pip install numpy pandas scikit-learn matplotlib seaborn imbalanced-learn networkx scikit-fuzzy - metrics.csv: Contains comprehensive per-class and aggregate metrics.
- confusion_matrices: Visual examination of classification errors.
- performance_metrics.png: Comparative analysis across classifiers.
- timing.csv: Computational efficiency assessment.
- Overall accuracy: 96-99% across algorithms and datasets.
- Average F1-Score: 0.97 (macro-averaged).
- Average training time: 0.82 seconds per fold (Intel i7-9700K).
- Average inference time: 0.14 seconds per test set.
- Ensemble method integration combining algorithm strengths.
- Hyperparameter optimization through Bayesian optimization.
- Deep learning extension for feature extraction.
- Online learning adaptation for streaming data.
If you use this implementation in your research, please cite:
@misc{iitp-classification-task,
  author = Yash Buddhadev,
  title = Multimodal Classification on Student and Network Traffic Data,
  year = 2025,
  publisher = buddhadevyash,
  url = https://github.com/buddhadevyash/IITP-Classification-Task
}